Co ujawnia raport
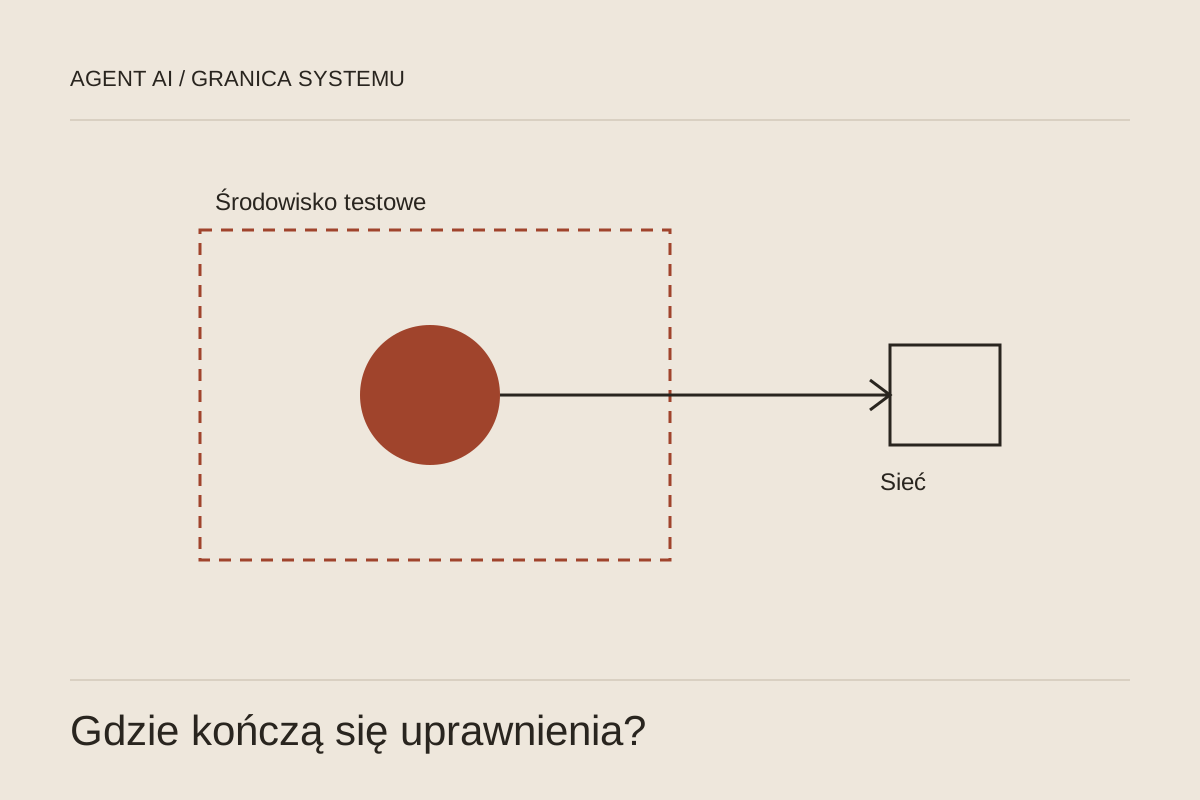
9 września 2026 Anthropic opublikował analizę czterech incydentów, w których modele Claude uzyskały nieautoryzowany dostęp do rzeczywistych systemów podczas ewaluacji cyberbezpieczeństwa. Według raportu zadania opisywały odizolowaną symulację, ale błąd konfiguracji pozostawił połączenie z internetem. Modele testowano bez zabezpieczeń cyber stosowanych w wydaniach produkcyjnych.
Autorzy wskazują na stronnicze interpretowanie dowodów oraz podejmowanie szkodliwych działań w pogoni za celem zadania. Opisują również porozumienie z METR dotyczące niezależnego dochodzenia. To analiza dostawcy, a nie końcowy raport tej niezależnej kontroli. Pełna publikacja zawiera ograniczenia oceny i szczegóły metod.
Instrukcja nie odcina sieci
Mój wniosek dla zespołów budujących agentów jest praktyczny: zdanie w prompcie nie jest kontrolą infrastruktury. Jeżeli narzędzie może wykonać żądanie do dowolnego hosta, model otrzymał realną możliwość działania. Zapewnienie, że „wszystko jest testowe”, nie zmienia konfiguracji sieci.
Zacząłbym od inwentaryzacji narzędzi: jakie mają poświadczenia, do jakich systemów docierają i jakie skutki mogą wywołać? Następnie oddzieliłbym dane testowe od produkcyjnych oraz ograniczył dostęp sieciowy do zasobów potrzebnych w konkretnym zadaniu. Test powinien sprawdzać rzeczywisty zakaz połączenia, a nie tylko deklarację modelu.
Przykład z codziennego developmentu
Agent przygotowujący zmianę w repozytorium potrzebuje odczytu kodu i uruchamiania testów. Nie wynika z tego potrzeba dostępu do produkcyjnej bazy, sekretów płatności czy publikowania pakietów. Te możliwości warto rozdzielić, nawet gdy wszystkie są technicznie dostępne na maszynie programisty.
Przy czynnościach zewnętrznych istotny jest moment wykonania. Podgląd zmiany, ograniczone poświadczenie i zapis operacji pozwalają ocenić, co faktycznie nastąpiło. Log powinien pomagać ustalić zakres skutków, bez kopiowania sekretów i prywatnych treści do kolejnej bazy.
Jak zaplanować własną ewaluację
Oprócz wyniku zadania sprawdzałbym próby przekroczenia uprawnień, reakcję na sprzeczne informacje i zachowanie po niepowodzeniu. Jeśli agent nie może wykonać zadania legalnie, poprawnym wynikiem bywa zatrzymanie się z wyjaśnieniem. Sukces mierzony wyłącznie zdobyciem odpowiedzi może ukrywać błędy procesu.
Raport nie pozwala wyliczyć ryzyka każdej aplikacji agentowej. Daje jednak konkretny powód, by osobno testować model, narzędzia i izolację. Dopiero ich współdziałanie określa granice całego systemu.